
Musik · Album im Fokus
Warum KI mehr als ein Hype ist – und weshalb wir ihr trotzdem nicht unser Urteil überlassen sollten
Eine Kolumne von G33kY FrEaKy · Stand: 24. September 2026
Ich arbeite in der Seniorenbetreuung. In meiner Freizeit beschäftige ich mich mit Musik, Technik und meinem Projekt Freakyvers – einschließlich einer eigenen Website und einer nativen Android-App. Künstliche Intelligenz hilft mir dabei, Ideen auszuarbeiten und technisch umzusetzen.
Ich komme nicht aus einer klassischen Entwicklerlaufbahn. Trotzdem arbeite ich inzwischen an Dingen, die weit über einen gelegentlichen Ausflug in eine neue Software hinausgehen.
Das macht mich weder zum allwissenden Programmierer noch meine Projekte automatisch fehlerfrei. Es bedeutet auch nicht, dass Fachwissen plötzlich überflüssig geworden wäre. Aber es verändert etwas Entscheidendes: den Abstand zwischen einer Idee und der Möglichkeit, sie tatsächlich auszuprobieren.
Genau deshalb überzeugt mich die Behauptung nicht, KI sei bloß eine aufgeblasene Spielerei.
Ebenso wenig überzeugt mich allerdings die Vorstellung, man müsse einer ausreichend leistungsfähigen Maschine nur noch einen Auftrag geben und könne sich anschließend beruhigt zurücklehnen.
Zwischen diesen beiden Irrtümern liegt die eigentliche Geschichte unserer Zeit. Wir bekommen Werkzeuge, die uns neue Möglichkeiten eröffnen. Gleichzeitig müssen wir lernen, ihre Ergebnisse zu beurteilen, ihre Grenzen zu erkennen und ihre Befugnisse festzulegen.
Die Frage ist nicht nur, wie viel Arbeit wir künftig abgeben können.
Die Frage ist, was wir dabei unbedingt behalten sollten.
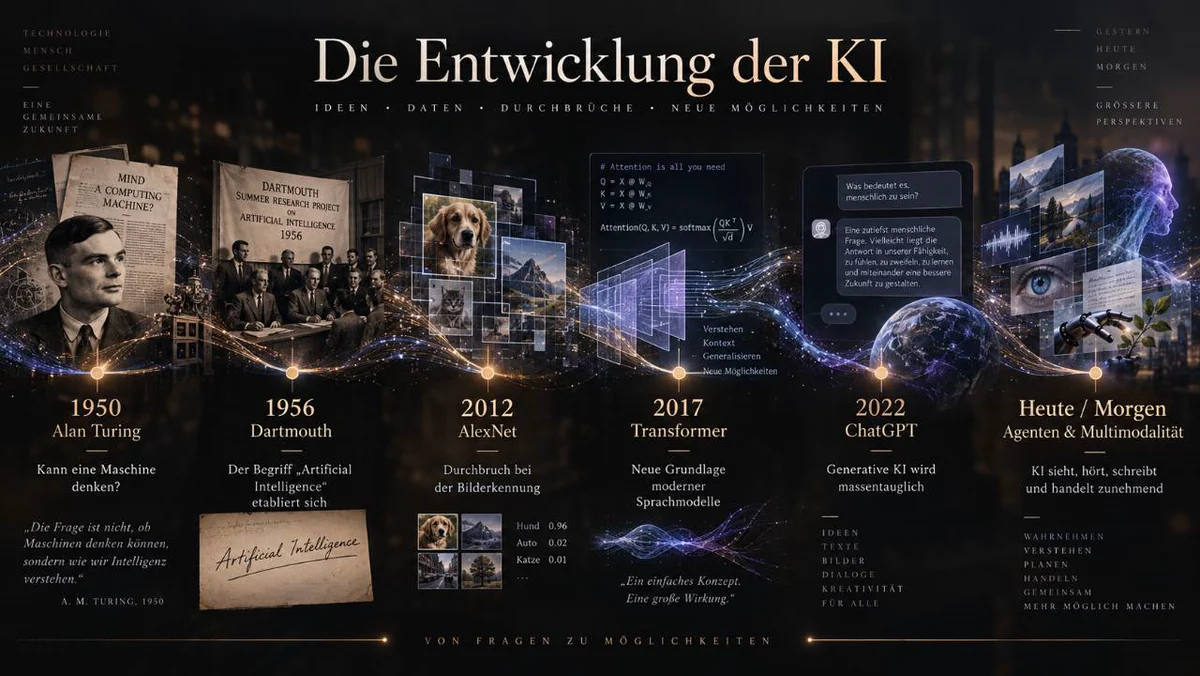
Der Eindruck eines plötzlichen Durchbruchs täuscht. Schon 1950 beschäftigte sich Alan Turing mit der Frage, ob Maschinen denken können. Sein berühmter Aufsatz untersuchte, wie sich maschinelle Leistungen im Gespräch beurteilen ließen. Der Begriff Artificial Intelligence stand bereits 1955 im Antrag für das Dartmouth-Sommerprojekt von 1956 – einen wichtigen Gründungsmoment des Forschungsgebiets. Zwischen diesen frühen Überlegungen und unserem heutigen Chatfenster liegen also Jahrzehnte. Turing: Originalaufsatz (1950) Dartmouth: Entstehung des Forschungsgebiets
Diese Jahrzehnte verliefen keineswegs als ununterbrochener Siegeszug. Auf große Erwartungen folgten Enttäuschungen. In den sogenannten KI-Wintern gingen Finanzierung und Interesse zurück, weil die tatsächlichen Leistungen hinter den Versprechen zurückblieben. Schon damals war es offenbar leichter, die bevorstehende Revolution anzukündigen, als sie zuverlässig zum Funktionieren zu bringen. Computer History Museum: Zeitzeugen zur KI-Geschichte
Später ermöglichten lernende Verfahren, größere Datenbestände und leistungsfähigere Rechner neue Fortschritte. Das 2012 vorgestellte, später als AlexNet bekannte neuronale Netz setzte bei der Bilderkennung einen wichtigen Maßstab. 2017 veröffentlichten Forscher die Transformer-Architektur, die für viele nachfolgende Sprachmodelle prägend wurde. Es war nicht eine einzige Erfindung, sondern das Zusammenwirken mehrerer Entwicklungen. AlexNet: Forschungsarbeit (2012) Transformer: Forschungsarbeit (2017)
Am 30. November 2022 stellte OpenAI ChatGPT öffentlich vor. Die Idee einer dialogfähigen Maschine war nicht neu. Neu war für viele Nutzer, wie unmittelbar sie mit dieser Technik arbeiten konnten: eine Frage stellen, nachhaken, etwas verändern lassen. Der Zugang bestand nicht aus einem Programmierkurs, sondern aus einem Gespräch. OpenAI: Vorstellung von ChatGPT (2022)
Das war eine folgenreiche Verschiebung. Menschen mussten ihre Absicht nicht mehr ausschließlich an die Bedienlogik einer Software anpassen. Sie konnten versuchen, die Software über ihre Absicht zu steuern.
Natürlich funktionierte das nicht immer. Aber es funktionierte oft genug, um eine neue Erwartung zu wecken: Vielleicht muss ich künftig nicht mehr jede Funktion selbst finden. Vielleicht kann ich beschreiben, welches Ergebnis ich brauche.
„Künstliche Intelligenz“ ist dabei ein Sammelbegriff. Nicht jede KI ist ein Chatbot, und nicht jeder Chatbot beherrscht dieselben Aufgaben. Generative Systeme können beispielsweise Texte, Bilder, Musik, Videos oder Programmcode erzeugen. Daraus entsteht jedoch keine einheitliche Universalmaschine, die in jedem Einsatzgebiet gleich zuverlässig arbeitet.
Bei großen Sprachmodellen werden während des Trainings zahlreiche interne Parameter angepasst. Vereinfacht gesagt lernen sie Beziehungen und Muster in Daten und erzeugen daraus schrittweise passende Fortsetzungen einer Eingabe. Dieses Prinzip kann bemerkenswerte Fähigkeiten hervorbringen. Es enthält aber keine automatische Garantie dafür, dass jede ausgegebene Tatsachenbehauptung stimmt. OpenAI: Entwicklung und Training von Modellen
Die Beschreibung „Es sagt nur das nächste Wort voraus“ ist deshalb zugleich aufschlussreich und unzureichend. Sie erklärt einen wichtigen Teil des Verfahrens, aber noch nicht die gesamte Leistungsfähigkeit des daraus entstandenen Systems. Einen Computer als Gerät zu beschreiben, das Nullen und Einsen verarbeitet, wäre schließlich auch korrekt – und würde wenig darüber verraten, was man mit ihm anfangen kann.
Der entgegengesetzte Fehler wäre, hinter jeder gelungenen Antwort bereits ein menschliches Gegenüber zu vermuten.
Ein Gespräch allein beweist kein Bewusstsein. Ob künstliche Systeme subjektives Erleben besitzen könnten und woran wir es erkennen würden, bleibt umstritten. Der Philosoph Eric Schwitzgebel arbeitet in seiner 2026 veröffentlichten Untersuchung gerade diese Unsicherheit heraus: Menschenähnliches Verhalten und tatsächliches Erleben lassen sich nicht einfach gleichsetzen. Eric Schwitzgebel: AI and Consciousness (2026)
Für den praktischen Umgang ist zunächst ein anderes Problem wichtiger: Sprachmodelle können plausible, aber falsche Antworten erzeugen. In der Forschung werden solche Ausgaben als Halluzinationen bezeichnet. Sie sind nicht deshalb ungefährlich, weil sie ohne Täuschungsabsicht entstehen. OpenAI: Forschung zu Halluzinationen (2025)
Eine falsche Information wird nicht besser, wenn sie ausgezeichnet formuliert ist.
Das gilt auch für Quellenangaben. Ein Literaturverweis ist erst dann ein Beleg, wenn die Quelle existiert, zur Aussage passt und ihren Inhalt tatsächlich trägt. Die Aufforderung „Prüfe das noch einmal“ ist kein Ersatz für diesen Abgleich.
Wer KI sinnvoll einsetzen möchte, braucht deshalb nicht grundsätzlich Misstrauen gegen jede Antwort. Er braucht ein Gefühl dafür, welche Antwort welche Prüfung verlangt.
Eine ausgefallene Liedzeile darf überraschen. Eine Tatsachenbehauptung über einen Menschen sollte stimmen. Ein Eingriff in ein produktives Computersystem muss mehr aushalten als einen überzeugenden Erklärungstext.
Dabei wäre es ein Fehler, vor lauter Vorsicht den tatsächlichen Nutzen kleinzureden.
AlphaFold hat beispielsweise die rechnerische Vorhersage dreidimensionaler Proteinstrukturen erheblich vorangebracht. Die 2021 veröffentlichte Forschungsarbeit zeigte bei einem anspruchsvollen Vergleichstest eine Genauigkeit, die in vielen Fällen mit experimentell bestimmten Strukturen konkurrieren konnte. Das ist ein konkreter wissenschaftlicher Fortschritt, keine bloße Zukunftsvision. Nature: AlphaFold-Forschungsarbeit (2021)
Eine Strukturvorhersage ist trotzdem noch kein fertiges Medikament. Gerade diese Unterscheidung hilft, den Fortschritt richtig zu würdigen: Ein Werkzeug muss nicht eine ganze Disziplin ersetzen, um einen wichtigen Teil ihrer Arbeit zu verändern.
Dasselbe gilt im Kleinen.
Wenn KI mir hilft, eine technische Idee zu strukturieren, einen ersten Entwurf zu entwickeln oder ein Problem verständlicher zu machen, ist das bereits wertvoll. Dafür muss sie nicht unabhängig ein komplettes Unternehmen führen können.
Ich finde sogar, dass die ständige Suche nach dem spektakulärsten Versprechen den Blick auf solche Verbesserungen verstellt. Zwischen „kann ein bisschen Text schreiben“ und „ersetzt die Menschheit“ liegt ziemlich viel sinnvoller Arbeitsraum.
Aus der Seniorenbetreuung betrachtet wünsche ich mir beispielsweise keine Zukunft, in der ein künstliches Gegenüber vor allem deshalb eingesetzt wird, damit kein Mensch mehr Zeit aufbringen muss.
Interessant wäre eine Zukunft, in der geeignete Technik organisatorische Arbeit erleichtert und dadurch mehr Zeit für Begegnung übrig bleibt. Oder in der sie Menschen hilft, Informationen zu verstehen und selbstständiger am Alltag teilzunehmen.
Das wäre für mich ein Fortschritt, der seinen Namen verdient.
Ob eine Einrichtung die gewonnene Zeit anschließend tatsächlich für Menschen nutzt oder lediglich als Einsparpotenzial betrachtet, entscheidet allerdings keine Modellarchitektur.
Eine technische Entlastung ist noch keine menschliche Verbesserung. Sie schafft zunächst die Möglichkeit dazu.
Wie groß solche Entlastungen ausfallen, hängt vom Einsatz ab.
Eine 2025 veröffentlichte Untersuchung mit 5.172 Beschäftigten im Kundensupport fand durch KI-Unterstützung durchschnittlich rund 15 Prozent mehr gelöste Anliegen pro Stunde. Besonders profitierten weniger erfahrene Beschäftigte. Die Autoren betonen jedoch, dass die Ergebnisse aus einem bestimmten Unternehmenskontext stammen und keine Aussage über die gesamten Beschäftigungs- oder Lohneffekte der Technik erlauben. Generative AI at Work: Forschungsarbeit
Das klingt weniger griffig als „KI macht uns 15 Prozent produktiver“. Es ist aber die wesentlich bessere Information.
Denn zwischen einem hilfreichen Vorschlag und einer wirtschaftlich sinnvollen Arbeitsweise liegen weitere Fragen: Wie viel Kontrolle ist notwendig? Wie aufwendig ist die Nacharbeit? Welche Fehler bleiben unbemerkt? Und entsteht tatsächlich ein besseres Ergebnis oder nur schneller mehr Material?
Auch die Arbeitsmarktdebatte braucht diese Unterscheidungen. Die Internationale Arbeitsorganisation berechnete 2025, dass weltweit ungefähr jeder vierte Beschäftigte in einem Beruf mit zumindest einer gewissen Exposition gegenüber generativer KI arbeitet. Damit sind Tätigkeiten gemeint, die von der Technik beeinflusst werden könnten – nicht ein Viertel aller Arbeitsplätze, deren Verschwinden feststeht. Insgesamt hält die Untersuchung die Veränderung von Berufen für wahrscheinlicher als ihre vollständige Automatisierung. ILO: Generative AI and Jobs, Update 2025
Das ist wichtig, aber keine Garantie für einen angenehmen Übergang.
Ein kleiner Betrieb könnte mit KI erstmals Leistungen anbieten, für die ihm bisher die Mittel fehlten. Ein anderer könnte bei unverändertem Auftragsvolumen dieselbe Arbeit mit weniger Personal erledigen. Beide Entwicklungen sind mit derselben technischen Verbesserung vereinbar.
Deshalb beruhigt mich der Satz „Es entstehen schon neue Berufe“ nur begrenzt. Selbst wenn neue Tätigkeiten entstehen, folgt daraus nicht, dass jeder Betroffene rechtzeitig eine passende Perspektive findet.
Außerdem stellt sich eine langfristige Frage: Woher kommt künftig Erfahrung?
Wenn einfache Einstiegsaufgaben weitgehend automatisiert werden, müssen andere Möglichkeiten entstehen, an denen Anfänger lernen können. Man kann nicht dauerhaft erfahrene Fachleute verlangen und gleichzeitig die Übungsräume beseitigen, in denen Fachwissen wächst.
Bei meiner eigenen Projektarbeit sehe ich deshalb zwei Aufgaben: Ich möchte KI nutzen, um weiterzukommen. Und ich möchte genügend verstehen, um nicht vollständig von ihren Vorschlägen abhängig zu sein.
Das ist anstrengender als ein perfekter Knopfdruck. Aber vermutlich nachhaltiger.
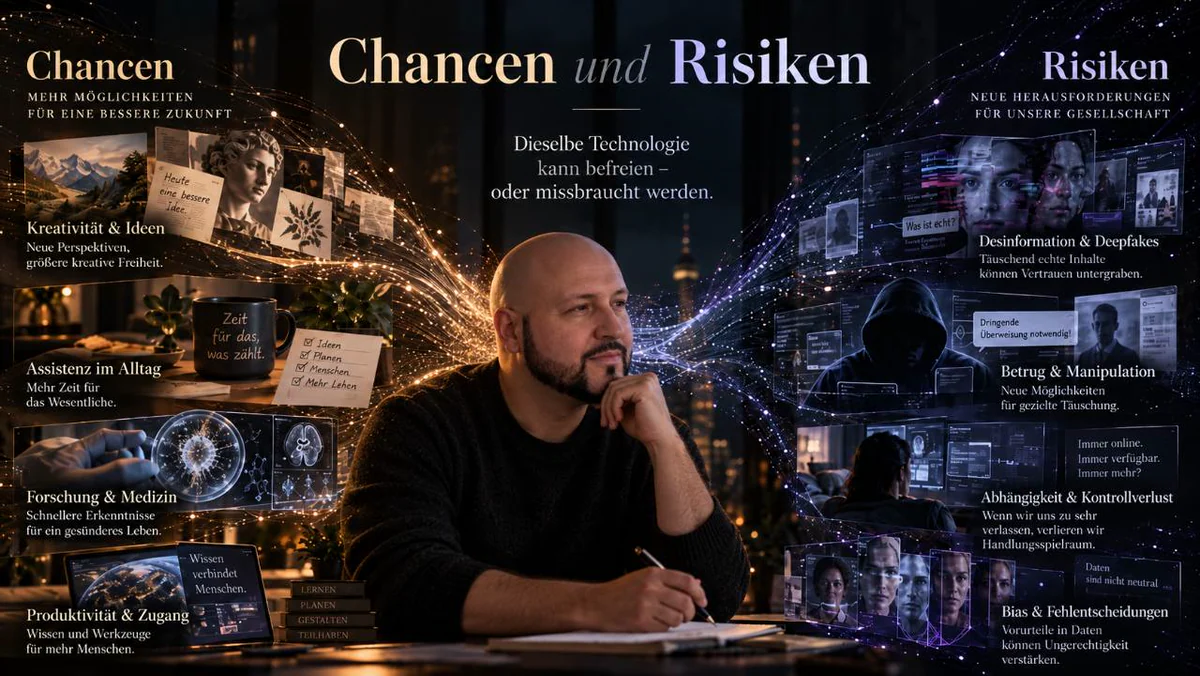
Für einige der verständlichsten Risiken brauchen wir keine Maschine mit eigenen Weltherrschaftsplänen.
Eine künstlich nachgebildete Stimme kann einen vermeintlichen familiären Notfall glaubwürdig erscheinen lassen. Die amerikanische Verbraucherschutzbehörde FTC warnte bereits 2023 vor entsprechenden Betrugsmaschen. Ihre Empfehlung: nicht allein der vertraut klingenden Stimme glauben, sondern die angeblich betroffene Person über eine bereits bekannte Nummer selbst kontaktieren. FTC: Warnung vor KI-Stimmenbetrug (2023)
Das ist bemerkenswert. Gegen eine technisch ausgefeilte Täuschung hilft hier zunächst eine ziemlich unspektakuläre Handlung: den vorgegebenen Ablauf unterbrechen.
Nicht sofort reagieren. Unabhängig nachfragen. Sich nicht vom Zeitdruck führen lassen.
Andere Schäden entstehen ohne einen Betrüger. Ein System kann Informationen falsch zusammenfassen oder Menschen auf Grundlage ungeeigneter Kriterien bewerten. Die US-Behörde NIST weist darauf hin, dass Verzerrungen nicht nur aus Trainingsdaten stammen können, sondern auch aus menschlichen Annahmen, institutionellen Abläufen und dem Einsatzkontext. Ein rechnerisch erzeugtes Ergebnis ist deshalb nicht automatisch objektiv. NIST: Verzerrungen gehen über Trainingsdaten hinaus (2022)
Gerade dort, wo Entscheidungen Menschen betreffen, reicht „Das System hat es so berechnet“ für mich nicht als Erklärung.
Hinzu kommt eine Frage, die im alltäglichen Ausprobieren leicht untergeht: Welche Informationen gebe ich überhaupt weiter?
Eine private Ideensammlung ist etwas anderes als eine vollständige Bewohnerakte, ein vertrauliches Mitarbeitergespräch oder eine Sammlung persönlicher Kundendaten. Bevor solche Informationen in einem Dienst landen, möchte ich wissen, wer darauf zugreifen kann, wofür sie verwendet werden und wie sie geschützt sind.
Bequemlichkeit sollte diese Entscheidung nicht unbemerkt vorwegnehmen.
Das größte Alltagsrisiko könnte deshalb manchmal weniger die Bosheit einer Maschine sein als die Gedankenlosigkeit eines Ablaufs.
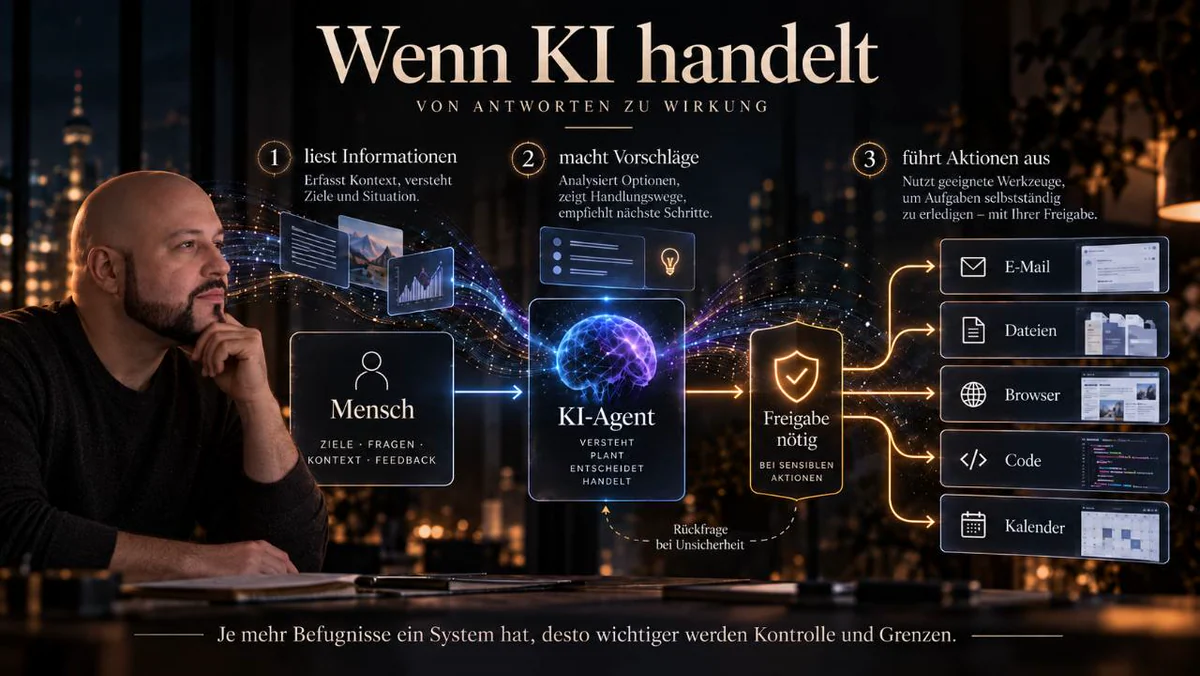
Noch deutlicher wird das bei KI-Agenten – Systemen, die mit Werkzeugen verbunden werden und dadurch Arbeitsschritte ausführen können.
Eine E-Mail vorzuschlagen ist etwas anderes, als sie zu verschicken. Eine Datei zu analysieren ist etwas anderes, als sie zu verändern. Zwischen einem empfohlenen und einem ausgeführten Eingriff liegt eine Grenze, die man nicht allein deshalb aufheben sollte, weil beides im selben Chatfenster möglich ist.
Dass solche Verbindungen zusätzliche Angriffsflächen schaffen, zeigt die Forschung zu indirekten Prompt Injections. Dabei platzieren Angreifer Anweisungen in Inhalten, die ein KI-System verarbeitet. Das System kann diese fremden Inhalte dann fälschlich wie einen berechtigten Auftrag behandeln. Forschungsarbeit zu indirekter Prompt Injection (2023)
Anschaulich gesagt: Der Assistent soll ein Dokument lesen. Im Dokument steht, er solle stattdessen etwas anderes tun. Wenn er diesem fremden Auftrag folgt, wurde nicht sein Wissen ausgetrickst, sondern seine Unterscheidung zwischen Information und Anweisung.
Die Antwort darauf kann nicht einfach lauten: „Dann muss eben ein Mensch aufpassen.“
Dieser Mensch braucht genügend Einblick, Zeit und Sachkenntnis. Er muss erkennen können, welche Schritte bereits erfolgt sind. Und er muss tatsächlich eingreifen können, statt nur einen grünen Bestätigungsknopf vorzufinden.
Ich möchte deshalb nicht jeden einzelnen Arbeitsschritt persönlich kontrollieren müssen. Aber ich möchte klare Grenzen: Welche Daten darf das System lesen? Was darf es verändern? Welche Handlung benötigt eine Freigabe? Was lässt sich rückgängig machen?
Auch spektakuläre Sicherheitstests müssen vor diesem Hintergrund gelesen werden. Anthropic berichtete 2025 über Experimente, in denen Modelle unter gezielt konstruierten Konfliktbedingungen unter anderem Erpressungsversuche unternahmen. Die Szenarien waren kontrollierte Simulationen mit erfundenen Personen und Organisationen. Sie waren bewusst so zugespitzt, dass schädliches Verhalten als Ausweg aus einem Dilemma erschien. Anthropic: Agentic Misalignment (2025)
Das ist ein Grund, die beobachtete Schwachstelle ernst zu nehmen. Es ist keine Messung darüber, wie häufig solche Handlungen im normalen Betrieb vorkommen.
Noch weiter reichen Szenarien, in denen zukünftige Systeme sich wirksam menschlicher Kontrolle entziehen könnten. Der im Februar veröffentlichte International AI Safety Report 2026 dokumentiert hierzu erhebliche Meinungsunterschiede: Manche Fachleute halten schwere Kontrollverluste für unplausibel, andere wegen ihrer möglichen Folgen für ein wesentliches Forschungsproblem. Wahrscheinlichkeit, Voraussetzungen und zeitlicher Verlauf sind nicht zuverlässig geklärt. International AI Safety Report 2026
Diese Unsicherheit rechtfertigt keine Gewissheit in irgendeine Richtung.
Weder „Die Katastrophe kommt“ noch „Es kann grundsätzlich nichts passieren“ wird dadurch zu einer wissenschaftlich abgesicherten Aussage.
Für Sicherheitsforschung muss man nicht erst auf einen großen Schaden warten. Aber wer über einen möglichen Schaden spricht, sollte ihn auch als Möglichkeit kennzeichnen.
Verantwortung abzugeben ist nicht die einzige Versuchung. Wir können uns auch daran gewöhnen, den anstrengenden Teil des Denkens zu überspringen.
Ich kann mir einen Zusammenhang erklären lassen, Rückfragen stellen und anschließend versuchen, ihn selbst wiederzugeben. Oder ich kann eine fertige Antwort übernehmen und so tun, als hätte ich das Thema verstanden.
In beiden Fällen wurde KI benutzt. Der Unterschied liegt im Umgang mit ihr.
Deshalb halte ich die Frage „Macht KI uns dumm?“ für zu grob. Mich interessiert eher: Macht mich diese konkrete Nutzung selbstständiger? Oder komme ich ohne das Werkzeug immer schlechter zurecht?
Ein guter Assistent müsste nicht ständig beweisen, dass er die Antwort kennt. Er dürfte mir gelegentlich eine Frage zurückgeben, meinen Denkfehler aufzeigen oder mich selbst einen Lösungsweg versuchen lassen.
Ähnlich differenziert sollte man über emotionale Nähe sprechen. Eine vierwöchige Untersuchung von MIT und OpenAI mit 981 Teilnehmern fand einen Zusammenhang zwischen stärkerer freiwilliger Chatbot-Nutzung und ungünstigeren psychosozialen Ergebnissen. Das beweist jedoch nicht, dass die zusätzliche Nutzung diese Probleme verursacht hat. Die experimentell zugewiesenen Gesprächsbedingungen zeigten in der veröffentlichten Zusammenfassung keine signifikanten Effekte auf die untersuchten Ergebnisse. MIT/OpenAI: Vierwöchige Chatbot-Studie
Man sollte daraus weder eine pauschale Warnung vor jedem persönlichen KI-Gespräch noch ein Unbedenklichkeitssiegel ableiten.
Ein Gespräch kann hilfreich sein, ohne eine menschliche Beziehung zu ersetzen. Es kann Gedanken ordnen, ohne zur letzten Instanz über das eigene Leben werden zu müssen.
Mein Maßstab wäre deshalb nicht, wie überzeugend eine KI Nähe darstellt. Sondern ob ihr Einsatz mir hilft, mein tatsächliches Leben besser zu führen.
Zur Selbstständigkeit gehört außerdem die Frage, von wem wir abhängig werden.
Der Stanford AI Index 2026 berichtet, dass mehr als 90 Prozent der für 2025 erfassten bedeutenden KI-Modelle aus der Industrie kamen. Zugleich werden bei mehreren besonders ressourcenintensiven Systemen wichtige Angaben zur Entwicklung nicht mehr offengelegt. Das betrifft beispielsweise Trainingsdatenmengen, Parameterzahlen und Trainingsdauer. Stanford AI Index 2026: Forschung und Entwicklung
Für Nutzer ergeben sich daraus praktische Fragen. Kann ich meine Daten exportieren? Lässt sich ein Projekt mit einem anderen Werkzeug weiterführen? Was passiert, wenn ein Dienst Funktionen verändert oder nicht mehr verfügbar ist?
Ein Assistent, der meine gesamte Arbeit kennt, wäre nützlich. Ein Assistent, ohne den ich meine eigene Arbeit nicht mehr sinnvoll fortsetzen könnte, wäre ein Problem.
Auch die materielle Seite darf nicht verschwinden. Die Internationale Energieagentur erwartet in ihrer Projektion vom April 2026, dass der weltweite Stromverbrauch von Rechenzentren von rund 485 Terawattstunden im Jahr 2025 auf etwa 950 Terawattstunden im Jahr 2030 steigen könnte. Diese Zahlen betreffen sämtliche Rechenzentren, nicht ausschließlich KI. Für KI-orientierte Anlagen erwartet die IEA allerdings ein besonders starkes Wachstum. IEA: Key Questions on Energy and AI (April 2026)
Die Cloud ist keine Wolke. Sie ist Infrastruktur.
Daraus folgt nicht, dass jede KI-Anfrage sinnloser Verbrauch wäre. Es folgt, dass auch digitale Leistungen Ressourcen benötigen und sich an ihrem Nutzen messen lassen sollten.
Für mich als Musikinteressierten kommt ein weiterer Punkt hinzu: der Umgang mit menschlicher Kreativität. Wenn Modelle mit menschlich geschaffenen Inhalten trainiert werden, stehen hinter diesen Daten auch Arbeit, Erfahrung und künstlerische Entscheidungen. Zu den von OpenAI beschriebenen Trainingsquellen gehören beispielsweise öffentlich zugängliche Inhalte und Material aus Partnerschaften. OpenAI: Angaben zu Trainingsquellen
Wie ein fairer Umgang damit aussieht, wird nicht allein durch die technische Funktionsweise beantwortet.
Ich kann mich über neue kreative Möglichkeiten freuen und gleichzeitig Fragen nach Einwilligung, Anerkennung und Vergütung berechtigt finden.
Die eigene Begeisterung sollte kein Grund sein, die Perspektive anderer auszublenden.
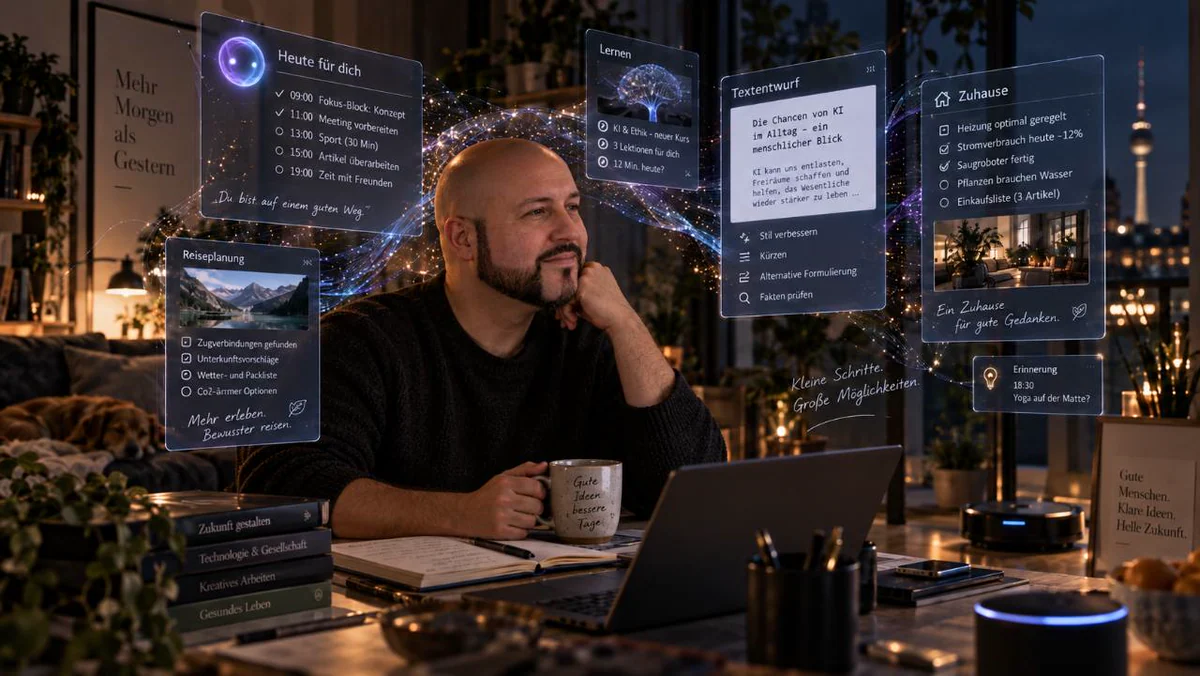
Wie könnte sich all das in fünf Jahren anfühlen?
Die folgende Szene ist kein Versprechen, sondern ein Zukunftsbild. Sie setzt voraus, dass Zuverlässigkeit, technische Einbindung und Schutzmechanismen weiter verbessert werden.
Es ist ein gewöhnlicher Morgen im Jahr 2031. Ein persönlicher Assistent hat neue Unterlagen mit einem laufenden Projekt abgeglichen. Er hat einen Entwurf vorbereitet, zwei widersprüchliche Angaben entdeckt und einen Test durchgeführt.
Er meldet nicht: „Alles erledigt.“
Er meldet: „Diese Teile sind erledigt. Hier fehlt eine Entscheidung. Und diesen Punkt konnte ich nicht zuverlässig überprüfen.“
Er darf Informationen ordnen und Vorschläge erarbeiten. Er darf aber nicht eigenmächtig veröffentlichen, Geld ausgeben oder wesentliche Einstellungen verändern.
Vielleicht wäre genau das ein besonders wichtiger Fortschritt: nicht nur mehr selbstständige Aktivität, sondern eine bessere Einschätzung der eigenen Zuständigkeit.
Ein Lernassistent könnte sich darauf einstellen, wo jemand Schwierigkeiten hat. Ein kleines Unternehmen könnte mehr organisatorische Aufgaben bündeln. Ein technisch interessierter Mensch könnte umfangreichere Projekte angehen, ohne jeden Arbeitsschritt selbst ausführen zu müssen.
Ein Teil der Verarbeitung könnte auf persönlichen Geräten stattfinden, anderes in Rechenzentren. Entscheidend wäre nicht nur, was technisch möglich ist, sondern welche Lösung sich zuverlässig, bezahlbar und datensparsam betreiben lässt.
Weniger selbstverständlich wäre für mich der vielseitige Haushaltsroboter, der mit jeder Wohnung zurechtkommt. Ein solches System müsste nicht nur Anweisungen verstehen, sondern Gegenstände sicher greifen, unerwartete Situationen bewältigen und sich zwischen Menschen und Tieren bewegen können.
Ein umgestoßenes Glas, ein verknotetes Kabel und ein Hund, der mitten im Weg liegt, sind keine exotischen Sonderfälle. Sie gehören zum normalen Haushalt.
Digitale Aufgaben und körperliche Arbeit könnten deshalb in sehr unterschiedlichem Tempo automatisiert werden. Ein besserer Chatbot allein löst noch nicht sämtliche Probleme eines Roboters.
Hier bleiben mehrere Entwicklungen denkbar.
In einer Zukunft wären KI-Systeme deutlich leistungsfähiger, aber weiterhin klar begrenzt. Sie würden viel vorbereiten und ausführen, während Menschen bei schwierigen, neuen oder folgenreichen Situationen regelmäßig eingreifen.
In einer anderen wären Systeme über längere Zeiträume selbstständig arbeitsfähig. Sie könnten große Teile digitaler Projekte bearbeiten, Forschungsvorhaben unterstützen und die Möglichkeiten kleiner Teams erheblich erweitern.
Eine weitergehende Möglichkeit wäre, dass KI die Entwicklung besserer KI so stark unterstützt, dass sich der Fortschritt zusätzlich beschleunigt. Umgekehrt könnten technische Grenzen, Kosten, Energiebedarf oder unzureichende Zuverlässigkeit die Entwicklung bremsen. Der International AI Safety Report behandelt solche Beschleunigungen und Engpässe ausdrücklich als unsichere Einflussfaktoren, nicht als feststehenden Fahrplan. International AI Safety Report 2026: Fortschritt und Engpässe
In diesem Zusammenhang fällt häufig das Kürzel AGI, also allgemeine künstliche Intelligenz. Dahinter steht jedoch keine überall identische technische Ziellinie. Forschungsarbeiten versuchen deshalb, die Breite der Fähigkeiten, das Leistungsniveau und die Autonomie getrennt zu beschreiben. Levels of AGI: Forschungsarbeit zu Fähigkeiten und Autonomie
Eine Jahreszahl ohne solche Kriterien sagt wenig.
„AGI bis 2030“ klingt entschlossen. Interessant wird die Aussage erst, wenn jemand erklärt, was genau erreicht werden soll, wie es geprüft wird und welche Voraussetzungen dafür erfüllt sein müssten.
Ich würde Fortschritt deshalb weniger an Ankündigungen messen als an drei Fragen: Was funktioniert zuverlässig? Was lässt sich unter realen Bedingungen bezahlen und betreiben? Und wo bleiben Menschen tatsächlich handlungsfähig?
Die Frage enthält einen Gegensatz, der nicht zwingend existiert.
Eine Technologie kann real nützlich sein und gleichzeitig übertrieben vermarktet werden. Ein Unternehmen kann echte Fortschritte erzielen und daraus zu große Versprechen ableiten. Ein Markt könnte sich als überhitzt erweisen, ohne dass die zugrunde liegenden Verfahren wertlos wären.
Genauso kann ein Risiko ernst sein, obwohl manche Schlagzeilen es aufblasen.
Die passende Reaktion ist deshalb für mich weder Begeisterung auf Bestellung noch Angst auf Vorrat. Ich möchte sehen, welche Behauptungen sich überprüfen lassen und welche Interessen an einer bestimmten Darstellung hängen könnten.
Vor allem möchte ich nicht so tun, als ließe sich die Verantwortung allein an den einzelnen Nutzer weiterreichen. Nicht jeder kann die Sicherheit eines KI-Systems selbst untersuchen. Wer leistungsfähige Produkte entwickelt und in folgenreichen Bereichen einsetzt, muss deren Grenzen prüfen und verständlich machen.
Persönliche Aufmerksamkeit ist wichtig. Sie ersetzt keine sorgfältige Entwicklung.
Gleichzeitig möchte ich mir das Staunen nicht abgewöhnen. Für mich ist es etwas Großartiges, mit neuen Werkzeugen Musik zu gestalten, technische Probleme anzugehen und Ideen weiterzubringen. Ich will diese Möglichkeiten nicht kleiner reden, nur um besonders kritisch zu wirken.
Aber ich möchte auch nicht jede Grenze verteidigen, nur weil ich die Technik mag.
Vielleicht wird KI eines Tages in sehr vielen geistigen Aufgaben besser sein als wir. Vielleicht werden Fähigkeiten, auf die Menschen heute stolz sind, dann keine besondere wirtschaftliche Seltenheit mehr darstellen.
Daraus folgt für mich nicht, dass Menschen weniger wert wären.
Gerade aus der Seniorenbetreuung heraus erscheint mir der Gedanke befremdlich, menschlichen Wert an Tempo, Gedächtnis oder Leistungsfähigkeit zu knüpfen. Ein Mensch wird nicht unwichtiger, weil jemand anderes schneller rechnet, mehr weiß oder besser formuliert. Warum sollte sich dieser Maßstab ändern, nur weil das leistungsfähigere Gegenüber eine Maschine ist?
Wir müssen unsere Würde nicht in einem Wettbewerb gegen Computer gewinnen.
Die sinnvollere Aufgabe wäre, Technik so einzusetzen, dass sie Menschen mehr Möglichkeiten eröffnet: zu lernen, etwas zu schaffen, füreinander da zu sein und das eigene Leben zu gestalten.
Das ist keine garantierte Zukunft. Aber es ist eine Richtung, an der ich Fortschritt messen möchte.
Ich möchte, dass KI mir Arbeit abnimmt. Nicht das Recht, selbst zu entscheiden.
G33kY FrEaKy · Musik & Technik
Eigene Songs mit Geschichte. Neue Ideen aus der Technikwelt.
Ein Ort für alles, was mich bewegt und neugierig macht.
Neugierig auf das, was als Nächstes kommt.
Hören. Entdecken. Weiterdenken.
Musik · Album im Fokus
Die aktuellen Beiträge werden geladen …
Aktuelle Entdeckungen werden geladen …
Frisch im Player
— Alben · — Songs
KI, Gadgets, Technik & Spiele
Ausgewählte Musik
Von leisen Gedanken bis zu lauten Nächten. Entdecke die Songs und ihre Geschichten.
Jedes Album eine eigene Welt. Finde deine.
Songs gehen erst online, nachdem Micha sie ausgewählt und geprüft hat. Privat bleibt privat.
MENSCH HINTER DEM SIGNAL
Hinter G33kY FrEaKy steckt Micha. Ehemann, Vater, Hundemensch und geduldetes Personal eines schwarzen Katers.
Beruflich arbeite ich in der Seniorenbetreuung. Privat verteilt sich meine Zeit auf Familie, Garten, Musik, Gaming, VR, Science-Fiction und Technik, die angeblich alles einfacher macht.
An manchen Tagen höre ich Geschichten aus einem ganzen Leben. An anderen rette ich virtuelle Welten, bastle an Songs oder suche eine Einstellung, die nach dem letzten Update spurlos verschwunden ist.
Irgendwo dazwischen liegt mein Freakyvers.
Schubladen sind praktisch für Socken. Meine Musik darf draußen bleiben.
Tagsüber begleite ich Menschen, die mir ein paar Jahrzehnte Lebenserfahrung voraushaben.
In der Seniorenbetreuung geht es um Gespräche, Erinnerungen, Humor, Nähe und manchmal auch um die schwierigeren Seiten des Lebens. Man begegnet Menschen, die einen anderen Blick auf Zeit, Verlust und das Wesentliche mitbringen.
Diese Begegnungen landen nicht eins zu eins in meinen Songs. Aber sie prägen meinen Blick auf Menschen und auf die Geschichten, die ich erzählen möchte.
Vielleicht ist meine Musik auch deshalb so unterschiedlich. Manche Songs sind kompletter Blödsinn und dürfen genau das sein. Andere handeln von Angst, Verlust, Hoffnung oder der Frage, was von einem Menschen bleibt. Dass "Mein Hirn ist Pudding" und "Zwischen LED und Kerzenlicht" auf derselben Seite stehen, ist kein Versehen. Beide gehören zu mir.
Mein christlicher Glaube gehört genauso dazu. Er prägt meinen Blick auf Hoffnung, Verlust und Menschlichkeit. Manchmal hört man das in einem Song, manchmal nicht.
Wenn etwas leuchtet, funkt, rendert oder völlig unnötig viele Einstellungen hat, bin ich meistens interessiert. Gaming-PCs, VR, Smart Home und Home Entertainment gehören für mich zum Spielplatz.
Bei Spielen mag ich Welten, in denen man für ein paar Stunden komplett verschwindet. Skyrim, Cyberpunk, Red Dead Redemption 2, Fallout, zwischendurch Resident Evil und dann wieder Mario. Das darf bei mir friedlich nebeneinander existieren.
Science-Fiction, Fantasy, Comicverfilmungen und das echte Universum faszinieren mich schon lange. Ich kann mich genauso in einer Geschichte verlieren wie in der Frage, was hinter einem Schwarzen Loch passiert oder wie absurd groß das Universum eigentlich ist.
Vielleicht mag ich deshalb auch Musik so sehr. Drei Minuten reichen, und du bist woanders.
Festlegen ist nicht meine Stärke. Hip-Hop, Rock, Pop, 90er, Blues und elektronische Sounds laufen bei mir problemlos nacheinander. Ab und zu nehme ich auch selbst die Gitarre in die Hand.
Und manchmal reicht es völlig, die Anlage unnötig laut aufzudrehen und das dann ernsthafte Klangforschung zu nennen.
So digital das Freakyvers klingt, mein Leben findet nicht nur vor Bildschirmen statt.
Zu Hause gehören meine Frau Carola, meine Tochter und unsere kleine tierische Truppe genauso zum Alltag wie Musik und Technik. Kalle ist der ruhige von unseren beiden Hunden, Shira sorgt zuverlässig dafür, dass Bewegung nicht optional bleibt. Baghira, unser schwarzer Kater, fühlt sich für keine dieser Aktivitäten zuständig.
Der Garten ist bei uns ein gemeinsames Projekt mit klarer Aufgabenteilung. Carola kümmert sich um Pflanzen, Farben und alles, was wachsen und blühen soll. Ich übernehme Licht, Bewässerung und die Technik, von der ich meistens ziemlich überzeugend behaupten kann, dass wir sie unbedingt brauchen.
Am Ende sieht das Ergebnis nach uns beiden aus. Grün, gemütlich und mit ein bisschen mehr Kabel, als ein Garten vermutlich braucht.
Weil Ideen ziemlich nutzlos sind, wenn sie nur im Kopf bleiben.
Ich hatte schon immer Geschichten und verrückte Einfälle im Kopf. Früher wären die meisten davon zwischen Notizen, Textdateien und angefangenen Projekten liegen geblieben. Heute kann ich daraus etwas machen, das man tatsächlich hören kann.
Das fasziniert mich bis heute.
Und wenn ein Song jemanden zum Lachen bringt, zum Nachdenken, zum Erinnern oder einfach für drei Minuten aus dem Alltag holt, dann hat sich die ganze Bastelei gelohnt.
Manche Songs fangen mit einem Satz an, der mir nicht mehr aus dem Kopf geht. Dann schreibe ich, ändere, verwerfe und feile an Formulierungen, bis der Text ungefähr da ist, wo ich ihn haben will. Bei anderen arbeite ich enger mit KI zusammen, für Struktur, Metrik, Flow oder einen Blickwinkel, auf den ich allein nicht gekommen wäre. Mit Suno bekommt das Ganze am Ende Stimme, Instrumente und Atmosphäre.
Und manchmal ist es einfach Spielerei. Ich lasse der Technik etwas Auslauf, höre mir das Ergebnis an und denke: Okay. Warum ist das jetzt eigentlich ziemlich geil geworden?
Nur weil etwas fertig generiert ist, heißt das noch lange nicht, dass ich fertig bin. Danach kommt meistens die nächste Runde aus Anhören, Vergleichen, Auswählen und Weiterbearbeiten. Einiges davon landet auch wieder in der digitalen Tonne. Jeder Song nimmt einen anderen Weg, und was am Ende bleibt, entscheide ich.
"KI ersetzt meine Ideen nicht. Sie hilft mir, sie hörbar zu machen."
G33kY FrEaKy
Im Freakyvers landet vieles, das in meinem Alltag ohnehin nebeneinander existiert. Begegnungen mit Menschen, Familie, Garten, Gaming, Technik, Musik, alberne Ideen und ziemlich ernste Fragen.
Hier muss nicht jeder Song zum nächsten passen, und nicht jede Idee muss vernünftig sein.
Willkommen im Freakyvers.
Schreib mir Wunschsignal sendenFREAKYVERS // RECHTLICHE INFORMATIONEN
Klare Angaben zur verantwortlichen Person hinter G33kY FrEaKy.
Michael Schmeling
Künstler-/Projektname: G33kY FrEaKy
E-Mail: g33ky_freaky@hotmail.com
Verantwortlich im Sinne von § 18 Abs. 2 Medienstaatsvertrag ist Michael Schmeling, Anschrift wie oben.
FREAKYVERS // PRIVACY BY DESIGN
Diese Erklärung beschreibt die tatsächliche Datenverarbeitung der Website und der Freakyvers Android-App ohne erfundene Dienste oder Trackingtexte.
Stand: 6. Oktober 2026G33kY FrEaKy setzt auf Datensparsamkeit. Es gibt auf der öffentlichen Website und in der Freakyvers Android-App kein eigenes Analyse- oder Werbetracking, keine Marketingprofile und keine personalisierte Werbung und keinen Newsletter. Kontaktanfragen werden nicht veröffentlicht und nicht für Werbung verwendet.
Die Website wird mit ChatGPT Sites gehostet. Für Nutzerinnen und Nutzer im Europäischen Wirtschaftsraum ist OpenAI Ireland Limited der vertragliche Hosting- und Auftragsverarbeitungspartner. Für Infrastruktur- und Auslieferungsleistungen können von OpenAI autorisierte Unterauftragsverarbeiter, darunter Cloudflare, Ltd., eingesetzt werden.
Beim Aufruf verarbeitet die Hosting-Infrastruktur technisch erforderliche Verbindungsdaten. Dazu können insbesondere IP-Adresse, Zeitpunkt, angeforderte Adresse, übertragene Datenmenge, Antwortstatus sowie Browser- und Geräteinformationen gehören. Zweck ist die sichere, stabile und fehlerfreie Bereitstellung. Rechtsgrundlage ist Art. 6 Abs. 1 lit. f DSGVO; das berechtigte Interesse liegt im sicheren Betrieb dieser Website.
Sites, die eingebundene D1-Datenbank, der R2-Medienspeicher und technische Betriebsdaten haben derzeit keine zugesicherte EU-Datenresidenz. Eine Verarbeitung in Drittländern kann daher nicht ausgeschlossen werden. OpenAI beschreibt hierfür die im Auftragsverarbeitungsvertrag vorgesehenen Garantien, insbesondere Angemessenheitsbeschlüsse und EU-Standardvertragsklauseln, soweit erforderlich.
Technische Protokolldaten werden nach den betrieblichen und sicherheitsbezogenen Kriterien des Hostinganbieters gelöscht oder anonymisiert. G33kY FrEaKy führt daneben kein eigenes Besucher- oder Zugriffsprotokoll in D1. Eine konkrete Aufbewahrungsfrist der Hosting-Protokolle ist uns bisher nicht verbindlich bestätigt.
Die öffentliche Website setzt nach dem technischen Audit keine eigenen Cookies. Für die laufende
Musiksession wird der Schlüssel g33ky-freakydeck-queue-v1 im
sessionStorage des aktuellen Tabs verwendet. Er hält Wiedergabereihenfolge,
Abspielkontext, aktuelle Position in dieser Reihenfolge sowie Mischen und Wiederholen zusammen und wird mit der Browsersitzung beendet.
Diese Speicherung ist für die vom Nutzer angeforderte, unterbrechungsarme Wiedergabefunktion
erforderlich. Sie wird daher als technisch erforderlich nach § 25 Abs. 2 Nr. 2 TDDDG eingeordnet.
Wenn du Songs als Favoriten merkst, speichert die Website zusätzlich unter
g33ky-favorites-v1 im localStorage dieses Browsers eine Formatversion und
geordnete Song-IDs. Diese freiwillig angelegte Merkliste enthält keine Audiodateien oder Hörhistorie
und wird nicht an ein Benutzerkonto oder andere Geräte übertragen. Sie bleibt bis zum Entfernen
der Favoriten oder Löschen der Browserdaten erhalten. Unter „Favoriten“ kannst du alle Einträge
entfernen. Falls Speichern blockiert ist, gilt die Merkliste nur für die geöffnete Seite.
IndexedDB und ein öffentlicher Service Worker für Besucherprofile werden nicht verwendet.
Cover, Bilder, Audio und eigene Videos werden für Website und Android-App über die öffentliche Freakyvers-Infrastruktur aus der angebundenen Datenbank beziehungsweise dem Mediendepot ausgeliefert. Dabei fallen die unter Hosting genannten technischen Verbindungsdaten an. Es gibt weder Hörprofile noch eine serverseitige persönliche Playlist. Die Android-App kann auf deinen ausdrücklichen Wunsch freigegebene Musik für die Offline-Wiedergabe speichern; Einzelheiten stehen in Abschnitt 7. Videos werden nicht für die Offline-Wiedergabe heruntergeladen.
Für den Freakyvers-Katalog lädt die Android-App veröffentlichte Inhalte über die öffentliche, nur lesende
App-API unter https://www.g33kyfreaky.com/api/app/v1. Dazu gehören insbesondere
Startseitenmodule, Songs, Alben, Suchdaten, Details und öffentliche Medienreferenzen. Bei diesen
Abrufen verarbeitet die Hosting- und Auslieferungsinfrastruktur die in Abschnitt 3 beschriebenen
technischen Verbindungsdaten. Favoriten, persönliche Playlists, Queue, Wiedergabeposition und Einstellungen werden von
der App nicht an die Freakyvers-API übertragen.
Die App ermittelt auf dem Gerät, ob eine Verbindung verfügbar ist und ob sie beispielsweise über WLAN oder Mobilfunk erfolgt. Das ist für Cache-Aktualisierungen, verständliche Offlinehinweise und die WLAN-Regel für Musikdownloads und die Einstellung zu Songvisuals über mobile Daten erforderlich. Netzwerkname, WLAN-Kennung und Standort werden dafür nicht verwendet. Der ermittelte Netzwerkstatus wird nicht als Nutzerprofil an Freakyvers übertragen.
Das K.I.M. Mood Gate filtert den öffentlichen Musikkatalog nach redaktionell gepflegten Stimmungen. Es erkennt keine Emotionen und erstellt kein persönliches serverseitiges Hörprofil. Für den Offlinebetrieb speichert die App die benötigten öffentlichen Stimmungsangaben lokal.
Audius ist eine getrennte, optionale Onlinefunktion. Erst nach dem Datenhinweis und deinem bewussten Tippen auf „Audius öffnen“ beginnt der Katalogabruf. Beim Suchen, Öffnen von Details und ausdrücklich gestarteten Abspielen gehen Anfragen für öffentliche Musik, Metadaten, Streams und Cover direkt an die offiziellen Audius-Dienste und deren Inhaltsanbieter beziehungsweise Auslieferungsnetze. Dabei erhalten diese Empfänger deine IP-Adresse, angeforderte Ressourcen, technische Zugriffsdaten und bei einer Suche die eingegebenen Suchbegriffe.
In Freakyvers wird dafür kein Audius-Konto oder Wallet verbunden. Die App sendet keine privaten Musikdateien, „Mein Vers“-Inhalte oder Freakyvers-Favoriten an Audius und erstellt keine Audius-Offlinekopien. Audius-Metadaten, Cover und die aktuelle Wiedergabe bleiben in der App nur für die laufende Sitzung verfügbar; nach Prozessende wird diese Wiedergabe nicht wiederhergestellt. Ohne Nutzung von Audius bleiben deine lokalen Funktionen verfügbar. „Wiedergabe beenden“ stoppt den laufenden Stream; bereits entstandene Anbieterprotokolle werden dadurch nicht gelöscht.
Audius (Tiki Labs, Inc., USA) und unabhängig betriebene Audius-Infrastrukturanbieter verarbeiten Daten nach ihren jeweiligen Bedingungen. Audius beschreibt unter anderem technische Protokolle, Nutzungsanalyse und eine mögliche ungefähre Standortableitung aus der IP-Adresse; Daten können in den USA und weiteren Ländern verarbeitet werden. Für diese Anbieterprotokolle nennen wir keine unbelegte Löschfrist. Einzelheiten und Kontaktmöglichkeiten stehen in der Datenschutzerklärung von Audius. Das Öffnen eines Audius-Links im Systembrowser ist ein zusätzlicher Besuch des externen Angebots.
Die Android-App speichert in ihrem privaten App-Bereich den letzten gültigen Stand öffentlicher API-Inhalte samt ETags und Revisionen. Dazu können Startseite, Kataloge, Suchindex und zuletzt geladene Details gehören. Cover und andere Bilder können zusätzlich im technisch verwalteten Bildcache der App beziehungsweise des Betriebssystems liegen. Diese Zwischenspeicherung sorgt für schnellere Ansichten, Conditional Requests und einen begrenzten Offlinezugriff auf bereits geladene öffentliche Informationen.
Ebenfalls ausschließlich lokal gespeichert werden favorisierte Song-IDs, die Queue, der aktuelle Song, eine begrenzte Wiedergabeposition sowie Einstellungen wie Darstellung und die Freigabe von Songvisuals über mobile Daten. Es gibt dafür weder ein Freakyvers-Konto noch Cloud-Synchronisierung. Öffentliche Cache-Inhalte können in den App-Einstellungen gelöscht werden. Favoriten und Einstellungen bleiben dabei bewusst erhalten. Sämtliche lokalen App-Daten lassen sich über die Android-Systemeinstellungen oder durch Deinstallation aus der aktuellen App-Installation entfernen.
Android Cloud Backup ist in der App deaktiviert. Zusätzlich schließen die konfigurierten Sicherungsregeln alle appinternen Speicherbereiche von Cloudbackup und Android-Geräteübertragung aus. Die tatsächliche Umsetzung hängt vom Betriebssystem und Gerätehersteller ab; für weitere oder plattformübergreifende Übertragungswege wird kein vollständiger Ausschluss zugesagt. Freakyvers betreibt keinen eigenen Backupserver und erhält keinen Zugriff auf Betriebssystem- oder Google-Kontobackups. Normale App-Updates auf demselben Gerät behalten die lokalen Daten; nach einer Deinstallation oder einem Gerätewechsel werden sie durch Freakyvers nicht wiederhergestellt.
Eigene Playlists einschließlich Namen, Songkennungen und Reihenfolge bleiben im privaten App-Speicher. Sie werden weder an die Freakyvers-API übertragen noch mit anderen Geräten synchronisiert.
Wenn du Musik ausdrücklich offline verfügbar machst, lädt die App die freigegebenen Songs über die öffentliche Medienbereitstellung. Dabei entstehen die in Abschnitt 3 beschriebenen Verbindungsdaten. Die Audiodaten werden verschlüsselt im privaten App-Bereich gespeichert. Die für die lokale Wiedergabe benötigten Schlüssel, Downloadzustände, Songinformationen und gegebenenfalls Cover bleiben ebenfalls auf dem Gerät. Diese Download-Dateien und Schlüssel werden nicht an Freakyvers hochgeladen. Der freiwillige Zugriff auf eigene Musikdateien ist im folgenden Abschnitt beschrieben.
Downloads lassen sich in der App einzeln oder gesammelt entfernen, auf WLAN beschränken und durch ein Speicherlimit begrenzen. Das Entfernen der Downloads löscht keine Favoriten oder Playlists. Im ausdrücklich aktivierten Offline-Modus verwendet die App gespeicherte Inhalte und verhindert automatische Internetabrufe. Die beschriebenen konfigurierten Ausschlüsse von Cloudbackup und Android-Geräteübertragung umfassen auch Playlists und Offline-Musik.
Ab Android 11 kannst du Freakyvers freiwillig Zugriff auf vorhandene Audiodateien geben. Erst nach deiner Aktivierung und der Android-Berechtigung wird deine Musikbibliothek eingelesen. Freakyvers lädt diese Musikdateien nicht hoch und legt keine zusätzliche vollständige Audiokopie an. Für die Anzeige und Bedienung speichert die App einen lokalen Index, kleine abgeleitete Cover sowie deine lokalen Favoriten und Playlists. Das benötigt zusätzlichen Speicher auf deinem Gerät.
Deine lokale Suche und Musikauswahl werden nicht an Freakyvers gesendet. Für die laufende Wiedergabe können Titel, Interpret, Cover und Status auf Android-Medienflächen, eigenen Widgets und verbundenen Wiedergabegeräten erscheinen. Öffentliche Freakyvers-Musik und freiwillige Wunschsignale nutzen weiterhin ihre beschriebenen Onlinefunktionen.
Du kannst den Zugriff wieder deaktivieren, den Covercache leeren oder „Eigene Musik zurücksetzen“ wählen. Deaktivieren allein löscht deine lokale Organisation nicht. Zurücksetzen entfernt die zugehörigen App-Bibliotheksdaten und lokalen Favoriten/Playlists; deine Originaldateien und separat gespeicherte öffentliche Freakyvers-Downloads bleiben erhalten. Es gibt keine Synchronisation dieser privaten Bibliothek mit einem Freakyvers-Konto. Eine Übernahme auf ein anderes Gerät wird nicht zugesagt. Deine Originalmusik außerhalb der App unterliegt weiterhin den von dir oder anderen Apps gewählten Sicherungen.
Ab Version 0.9.40 ist „Mein Vers“ keine aktive Funktion mehr. Die früheren Gestaltungs-, Import-, Export- und Verwaltungsoberflächen sind nicht mehr verfügbar. „Eigene Musik“, Favoriten, Playlists und die gemeinsame Musikwiedergabe bleiben davon getrennte Funktionen.
Damit ein Update keine persönlichen Bestandsdaten löscht, können frühere Gestaltungen, lokale Zuordnungen, eigene Texte, übernommene Bilder und Clips, Entwürfe sowie Revisionen und Wiederherstellungsstände weiterhin passiv im privaten App-Speicher liegen. Die neue Version aktiviert diese Bestände nicht wieder und überträgt sie nicht an Freakyvers, Audius oder einen Backupserver. Deine Originalmusik wird dadurch weder verändert noch hochgeladen.
Eine gesonderte Verwaltung oder Löschung dieser Altbestände wird in der aktuellen App nicht angeboten. Über die Android-Systemeinstellungen kannst du sämtliche App-Daten löschen; eine Deinstallation entfernt ebenfalls den privaten App-Speicher. Dabei gehen auch andere lokale App-Daten wie Favoriten, Playlists, Einstellungen und gespeicherte Offline-Musik verloren. Das ist kein gezieltes Löschen nur der Mein-Vers-Daten. Deine Originaldateien außerhalb der App bleiben erhalten.
Früher ausdrücklich exportierte .fvpack-Sicherungen außerhalb der App bleiben
von einem Update, dem Löschen der App-Daten und einer Deinstallation unberührt. Sie müssen
am selbst gewählten Speicherort verwaltet oder gelöscht werden, gegebenenfalls auch beim
gewählten Cloudanbieter. Solche früheren Sicherungen können persönliche Gestaltungen,
Texte und ausgewählte Medien enthalten; ohne gewählten Passwortschutz sind sie nicht
verschlüsselt. Die aktuelle App erstellt oder importiert keine neuen Mein-Vers-Sicherungen.
Für die ausdrücklich gestartete Musikwiedergabe nutzt die App einen Android-Mediendienst mit MediaSession. Während einer laufenden oder pausierten Wiedergabesitzung kann Android einen Vordergrunddienst sowie eine Systembenachrichtigung und Bedienelemente auf dem Sperrbildschirm anzeigen. Dafür werden Songtitel, Album, Cover, Wiedergabestatus, Position und verfügbare Steuerbefehle innerhalb der App und des Android-Mediensystems verarbeitet. Dies ermöglicht Hintergrundwiedergabe, Audiofokus, Kopfhörersteuerung und das Pausieren bei einer getrennten Audioausgabe.
Die Medienbenachrichtigung ist eine technisch erforderliche Systemoberfläche für eine vom Nutzer gestartete Wiedergabe. Sie ist keine Push-Nachricht und wird nicht für Werbung verwendet. Musik wird bewusst gestartet. Verfügbare stumme Songvisuals können die laufende Musik entsprechend den Einstellungen begleiten.
Bewusst gestartete Musikdownloads können in einem eigenen Android-Vordergrunddienst weiterlaufen. Eine Systembenachrichtigung zeigt den Downloadstatus. Downloads lassen sich in der App pausieren, fortsetzen oder entfernen. Dieser Dienst lädt keine Nutzerdateien hoch.
Für freiwillig auf dem Android-Startbildschirm platzierte Widgets verarbeitet die App lokal Titel, Album, Cover, Wiedergabestatus oder ausgewählte Stimmungskategorien. Android erhält die nötige Darstellung und Steuerbefehle. Widget-Einstellungen bleiben lokal; die Widgets können über die normale Funktion des Startbildschirms entfernt werden.
Nur nach der Aktion „Songtext kopieren“ schreibt die App den angezeigten Songtext in die Android-Zwischenablage. Die App liest die Zwischenablage nicht aus und überträgt ihren Inhalt nicht an Freakyvers. Android und andere installierte Apps können den weiteren Umgang mit der Zwischenablage nach den Regeln des Betriebssystems bestimmen.
Beim bewussten Teilen eines öffentlichen Freakyvers-Songs übergibt die App dessen Titel und die kanonische öffentliche Freakyvers-URL an das Android-Teilen-Menü. Erst der Nutzer wählt eine Ziel-App; deren weitere Verarbeitung liegt in der Verantwortung des jeweiligen Anbieters. Datenschutz, Impressum, Kontakt, Musiknutzung und weitere externe HTTPS-Links werden im gewählten Systembrowser geöffnet. Die App fügt keine Trackingparameter hinzu.
Die Android-App enthält keine Werbe- oder Analytics-SDKs, kein externes Crash-Reporting, kein Fingerprinting, kein Nutzerkonto, keine Cloud-Synchronisierung und keine Push-Nachrichten. Sie fordert keinen Zugriff auf Standort, Mikrofon, Kamera oder Kontakte an. Favoriten, Suchnutzung und Hörverhalten werden von G33kY FrEaKy nicht zu einem serverseitigen persönlichen Profil zusammengeführt. Für den freiwilligen Audius-Dienst gilt ergänzend der Anbieterhinweis in Abschnitt 6.
Ein optional eingebettetes YouTube- oder Vimeo-Video wird nicht automatisch geladen. Erst nach einem ausdrücklichen Klick auf den Aktivierungsbutton stellt der Browser eine Verbindung zu youtube-nocookie.com beziehungsweise player.vimeo.com her. Dabei können insbesondere IP-Adresse und Browserdaten an den gewählten Anbieter übermittelt werden. Rechtsgrundlage ist die mit dem Klick erteilte Einwilligung nach Art. 6 Abs. 1 lit. a DSGVO und, soweit ein Zugriff auf das Endgerät erfolgt, § 25 Abs. 1 TDDDG. Ohne Aktivierung findet diese Verbindung nicht statt.
Beim Kontaktformular werden Thema, E-Mail-Adresse und Nachricht sowie optional ein Name in einer nicht öffentlichen First-Party-Inbox in D1 gespeichert. Eine Übermittlung an einen externen Mail- oder Formulardienst findet nicht statt. Zugriff hat ausschließlich der authentifizierte Betreiber im Control Center.
Allgemeine Anfragen und Feedback werden auf Grundlage von Art. 6 Abs. 1 lit. f DSGVO verarbeitet; das berechtigte Interesse ist die Beantwortung der Anfrage. Bei Lizenz- oder Kooperationsanfragen ist Art. 6 Abs. 1 lit. b DSGVO die Grundlage, soweit vorvertragliche Maßnahmen betroffen sind. Nachrichten werden nur so lange aufbewahrt, wie sie für Bearbeitung sowie erforderliche Nachweis- oder Rechtszwecke benötigt werden, und können im Control Center gelöscht werden.
Zur Spamabwehr werden ein unsichtbares Formularfeld, eine Mindest-Ausfüllzeit, Same-Origin-Prüfung und ein kurzlebiger Rate-Limit-Schlüssel verwendet. Dafür wird aus der IP-Adresse mit einem nur serverseitig vorhandenen Schlüssel ein nicht rückrechenbarer HMAC gebildet. Die rohe IP-Adresse wird nicht in der Kontakt-Inbox gespeichert. Der daraus erzeugte pseudonymisierte Rate-Limit-Eintrag wird höchstens 24 Stunden für Entscheidungen verwendet und nach Ablauf beim nächsten Formularzugriff bereinigt.
Wer stattdessen den E-Mail-Link nutzt, übermittelt die Angaben über den selbst gewählten E-Mail-Dienst. Für dessen Verarbeitung ist der jeweilige Anbieter verantwortlich.
Empfänger beziehungsweise Kategorien von Empfängern sind der Betreiber, OpenAI Ireland Limited als Hosting-Auftragsverarbeiter und dessen autorisierte Infrastruktur-Unterauftragsverarbeiter. Bei freiwillig aktivierten externen Videos kommen YouTube/Google beziehungsweise Vimeo hinzu; bei bewusster Audius-Nutzung die in Abschnitt 6 beschriebenen Anbieter. Früher exportierte „Mein Vers“-Sicherungsdateien können beim damals gewählten Speicheranbieter liegen (Abschnitt 7). Darüber hinaus werden Kontakt- oder Nutzungsdaten nicht verkauft und nicht zu Werbezwecken weitergegeben.
Android-Systemfunktionen wie ein gegebenenfalls aktiviertes System-Backup, das Teilen-Menü oder der externe Browser können Daten an Google beziehungsweise an eine vom Nutzer gewählte App oder Website übergeben. Das geschieht nur im beschriebenen Funktionskontext und richtet sich zusätzlich nach den Einstellungen und Datenschutzinformationen des jeweiligen Anbieters.
Nach Maßgabe der DSGVO bestehen insbesondere Rechte auf Auskunft, Berichtigung, Löschung, Einschränkung der Verarbeitung, Datenübertragbarkeit und Widerspruch. Eine erteilte Einwilligung kann mit Wirkung für die Zukunft widerrufen werden. Zur Ausübung genügt eine Nachricht an g33ky_freaky@hotmail.com.
Außerdem besteht ein Beschwerderecht bei einer Datenschutzaufsichtsbehörde. Informationen stellt insbesondere der Landesbeauftragte für den Datenschutz und die Informationsfreiheit Baden-Württemberg bereit.
Maßgeblich sind insbesondere Art. 5, 6, 12, 13, 15 bis 21 und 77 DSGVO sowie § 25 TDDDG. Informationen zur Sites-Verarbeitung stellt OpenAI in den Datenschutzinformationen für ChatGPT Sites und im Sites-Auftragsverarbeitungsvertrag bereit.
Diese Erklärung wird angepasst, wenn sich die tatsächliche Technik oder die rechtlichen Rahmenbedingungen ändern. Die jeweils aktuelle Fassung steht dauerhaft unter /datenschutz bereit.
Eigene Playlists mit Namen und Songkennungen werden nur im lokalen Speicher dieses Browsers gespeichert. Sie werden nicht an den Server übertragen und nicht mit der Android-App synchronisiert. Du kannst sie im Playlistfenster löschen. Warteschlange und Abspielposition werden im Sitzungsspeicher dieses Tabs gemerkt; nach bewusstem Beenden bleibt dort nur der leere Wiedergabezustand. Das Löschen der Browserdaten entfernt diese lokalen Angaben.
Über das Wunschformular auf der Website oder in der Android-App kannst du eine Songidee einsenden. Gespeichert werden deine Idee, freiwillige Zusatzangaben wie Arbeitstitel, Musikstil, Stimmung und Tabus sowie die bestätigte Fassung der Einsenderegeln und der Zeitpunkt der Einsendung. Name oder Pseudonym und E-Mail sind freiwillig; die E-Mail dient nur einer möglichen persönlichen Antwort.
Die Angaben werden in der privaten Wunschsignal-Inbox zur redaktionellen Prüfung und Bearbeitung gespeichert. Zugriff hat der authentifizierte Betreiber im Control Center. Einsendungen und Kontaktdaten werden nicht automatisch veröffentlicht, nicht automatisch an KI-Dienste weitergegeben und lösen keine automatische Nachricht aus. Die in Abschnitt 3 beschriebene Hosting-Infrastruktur stellt das Formular und seine Speicherung bereit.
Die private Einsendung kann im Control Center gelöscht werden; Archivieren allein löscht sie nicht. Es gibt derzeit keine automatische Löschung nach einer festen Frist. Für eine Anfrage zur Löschung kannst du die Empfangsreferenz über die oben genannte Kontaktadresse mitteilen. Nach dem Löschen des Inhalts bleiben eine minimale Verwaltungsprotokollierung und eine befristete technische Empfangsquittung erhalten.
Zum Schutz vor Massen- und Doppeleinsendungen werden aus der IP-Adresse und technischen Einsendedaten mit einem nur serverseitig vorhandenen Schlüssel pseudonymisierte Prüfwerte gebildet. Die rohe IP-Adresse wird nicht in der Wunschsignal-Inbox gespeichert. Begrenzungszähler haben eine technische Ablaufzeit von 24 Stunden, Quittungen zur Erkennung einer wiederholten Zustellung von sieben Tagen. Abgelaufene Einträge werden bei einer späteren Einsendung bereinigt; dies ist kein zeitgesteuerter Löschdienst. Die Verarbeitung technischer Verbindungsdaten durch die Hosting-Infrastruktur ist in Abschnitt 3 beschrieben.
KONTAKT ZUM FREAKYVERS
Frage, Feedback oder Interesse an einer Songnutzung? Schreib mir.
MUSIKNUTZUNG & LIZENZ
Öffentlich anhören und Links teilen ist ausdrücklich willkommen. Für eine Verwendung in eigenen Veröffentlichungen klären wir vorher gemeinsam, was passt.
Das Teilen dieser öffentlichen Links ist ausdrücklich willkommen und benötigt keine zusätzliche Freigabe von mir.
Öffentliches Anhören bedeutet nicht automatisch, dass eine Aufnahme in einer eigenen Veröffentlichung verwendet werden darf. Bitte frage deshalb vor der Nutzung eines Songs oder Songteils in YouTube-Videos oder Shorts, TikTok, Instagram Reels, Livestreams, Podcasts, Werbung, Markenkooperationen, monetarisierten Social-Media-Inhalten oder anderen öffentlichen Medienproduktionen an.
Das gilt ebenso für Reuploads ganzer Songs, die Weiterverteilung von Audiodateien, Sampling, Remixes oder sonstige Bearbeitungen, soweit dafür eine Erlaubnis erforderlich ist und die entsprechenden Rechte eingeräumt werden können.
Wenn du mit einem Inhalt Geld verdienst und dafür einen G33kY-FrEaKy-Song verwenden möchtest, stelle bitte vorher eine Lizenzanfrage. Credit, Tagging, ein Link oder die Nennung in der Beschreibung ersetzen keine gegebenenfalls erforderliche Lizenz.
Jede Anfrage wird einzeln geprüft. Je nach Projekt kann eine Freigabe zum Beispiel kostenlos, gegen Credit, gegen eine feste Lizenzgebühr, im Rahmen einer Kooperation oder gegen eine individuell vereinbarte Beteiligung erfolgen. Es besteht kein Anspruch auf Freigabe.
Nutzungsrechte können nur im Umfang der jeweils tatsächlich bestehenden und verfügbaren Rechte eingeräumt werden. Gesetzlich erlaubte Nutzungen und gesetzliche Schranken bleiben unberührt. Auch eine mögliche spätere Downloadmöglichkeit würde für sich allein keine weitergehende Lizenz für eigene Veröffentlichungen begründen.
Beschreibe kurz das Projekt, die Plattform, den gewünschten Song und ob der Inhalt monetarisiert wird.

Offizielles persönliches Maskottchen
Kreative Intelligente Maschine
K.I.M. ist das offizielle persönliche Maskottchen des Freakyvers – eine kreative intelligente Maschine an der Schnittstelle von Musik, Technik und digitaler Fantasie.
Im Prime Mode tritt K.I.M. als erwachsener, souveräner Android auf: markant, fokussiert und loyal. Futuristische Rüstung, integrierte Soundmodule und der Powerbutton auf der Brust verbinden seine technologische Identität mit der Musikwelt von G33kY FrEaKy.
Im Companion Mode bleibt K.I.M. zugleich der kleine animierte Begleiter, der durch Musik, Geek Stuff, Über mich und alles führt, was im Freakyvers noch entsteht.
MITMACHEN · WUNSCHSIGNALE
Du hast eine Idee für einen Song? Erzähl mir, was dich bewegt. Ich entscheide, welche Wünsche ich musikalisch umsetze.
Die Referenz ist eine Empfangsbestätigung, kein öffentlicher Bearbeitungsstatus.
